
Voor het lokaal genereren van afbeeldingen op mijn MacBook met M1-chip heb ik een aantal populaire AI-beeldmodellen getest. Het doel was om te ontdekken hoe deze modellen zich in de praktijk tot elkaar verhouden en vooral hoe goed ze presteren op hardware die niet specifiek voor zware AI-workloads is ontworpen. De modellen die ik heb getest zijn:
- Flux 2 Klein (4B)
- Z-Image Turbo (6B)
- Krea 2 Turbo (13B)
- Qwen Image 2512 (inclusief Lighting Lora) (20B)
Modelgrootte
Bij het kiezen van een open source model voor het genereren van afbeeldingen heb je verschillende opties. Een belangrijke factor daarbij is het aantal parameters waaruit een model bestaat. Hoe meer parameters een model heeft, hoe meer rekenkracht en geheugen het doorgaans nodig heeft. Op een Mac M1 met 16 GB geheugen kan een groot model daardoor al snel te zwaar zijn om prettig mee te werken.
Het aantal parameters wordt aangeduid met B, wat staat voor billion (miljard). Zo heeft een 4B-model ongeveer 4 miljard parameters. Over het algemeen geldt dat kleinere modellen minder geheugen gebruiken en sneller werken. Grotere modellen hebben daarentegen meer capaciteit om complexe details te verwerken en kunnen daardoor kwalitatief betere resultaten opleveren. In deze test kijk ik daarom naar modellen die variëren van 4B tot 20B.
Model varianten
Veel open source-modellen hebben naast hun standaardversie ook distilled varianten. Deze worden vaak aangeduid met namen als “Turbo”, “Klein”, “Lightning” of “Distilled”. Dit is vaak een aanwijzing dat het model is geoptimaliseerd om met minder rekenkracht en aanzienlijk minder stappen een afbeelding te genereren.
Om te begrijpen waarom dat verschil belangrijk is, is het goed om te weten hoe een diffusionmodel werkt. Het model begint met ruis en verwijdert die vervolgens stap voor stap totdat er een afbeelding ontstaat. Elke stap is een berekening waarbij het model de afbeelding verder verfijnt. Hoe meer stappen nodig zijn, hoe langer het duurt om een afbeelding te genereren.
Een standaardmodel kan bijvoorbeeld 30 tot 50 stappen nodig hebben om tot een goed resultaat te komen. Een Turbo- of Lightning-variant is juist getraind of aangepast om met veel minder stappen een vergelijkbaar resultaat te bereiken. Sommige modellen kunnen daardoor al met 4 tot 8 stappen een bruikbaar resultaat produceren.
Modelprecisie en quantization
Als je afbeeldingen lokaal op een Mac met een beperkte hoeveelheid geheugen wilt genereren, kom je al snel GGUF tegen. GGUF is een bestandsformaat waarin modellen efficiënt kunnen worden opgeslagen, vaak met behulp van quantization. Hierbij worden de gewichten van een model met minder bits opgeslagen, waardoor het model aanzienlijk minder geheugen nodig heeft.
Er bestaan verschillende quantization-niveaus, zoals Q4, Q5, Q6 en Q8. Hoe lager het aantal bits, hoe kleiner het model doorgaans wordt en hoe minder geheugen het gebruikt. Daar staat tegenover dat een sterkere quantization in sommige gevallen tot een klein kwaliteitsverlies kan leiden.
Naast GGUF kom je ook andere formaten tegen, zoals BF16 en FP8. Dit zijn geen quantizationformaten zoals Q4 of Q8, maar verschillende manieren om de modelgewichten numeriek op te slaan. BF16 gebruikt 16 bits per waarde en biedt een hoge precisie, terwijl FP8 met 8 bits aanzienlijk minder geheugen gebruikt. FP8 is vooral interessant op hardware met native FP8-ondersteuning. De GPU’s in de Apple Silicon M1-generatie hebben geen native FP8-ondersteuning zoals moderne NVIDIA-GPU’s die wel hebben.
Voor een Mac M1 met 16 GB geheugen zijn vooral gequantiseerde modellen interessant. Een model dat in BF16 te groot is om lokaal te draaien, kan in bijvoorbeeld Q4-formaat soms wél binnen het beschikbare geheugen passen. De precieze geheugenwinst en eventuele kwaliteitsverschillen zijn afhankelijk van het model en de gebruikte quantization.
Workflow in ComfyUI

Voor alle modellen gebruik in dezelfde workflow.
- GGUF Unit Loader
- CLIP Loader
- VAE Loader
- CLIP Text Encoders
- KSampler
- Empty Latent Tmage
- VAE Decoder
- Save Image
- Lighting Lora (Voor Qwen Image 2512)
Om te werken met GGUF heb je niet het standaard Load Diffusion Model node nodig. Hiervoor heb je een Unit Loader nodig.
Dit zijn de modellen die ik gebruik:
Download workflows
De benchmarks
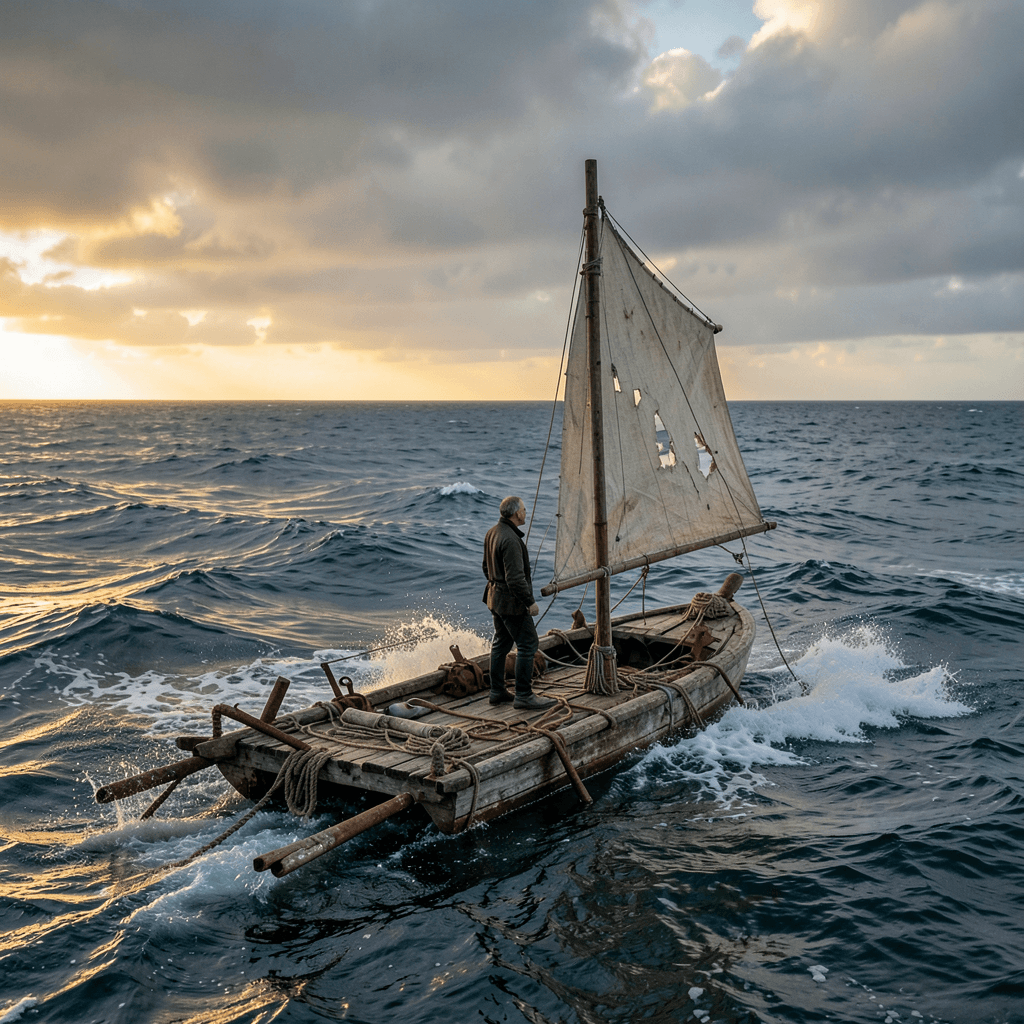
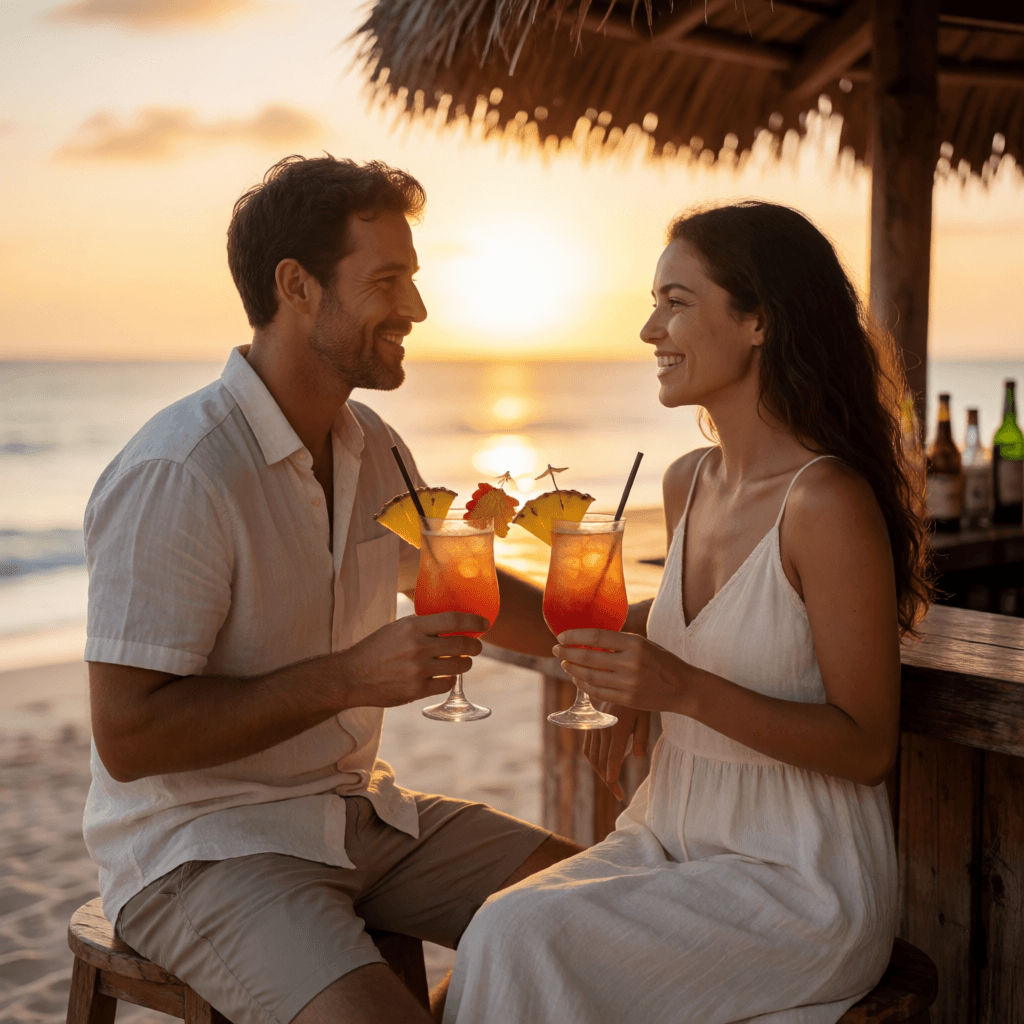
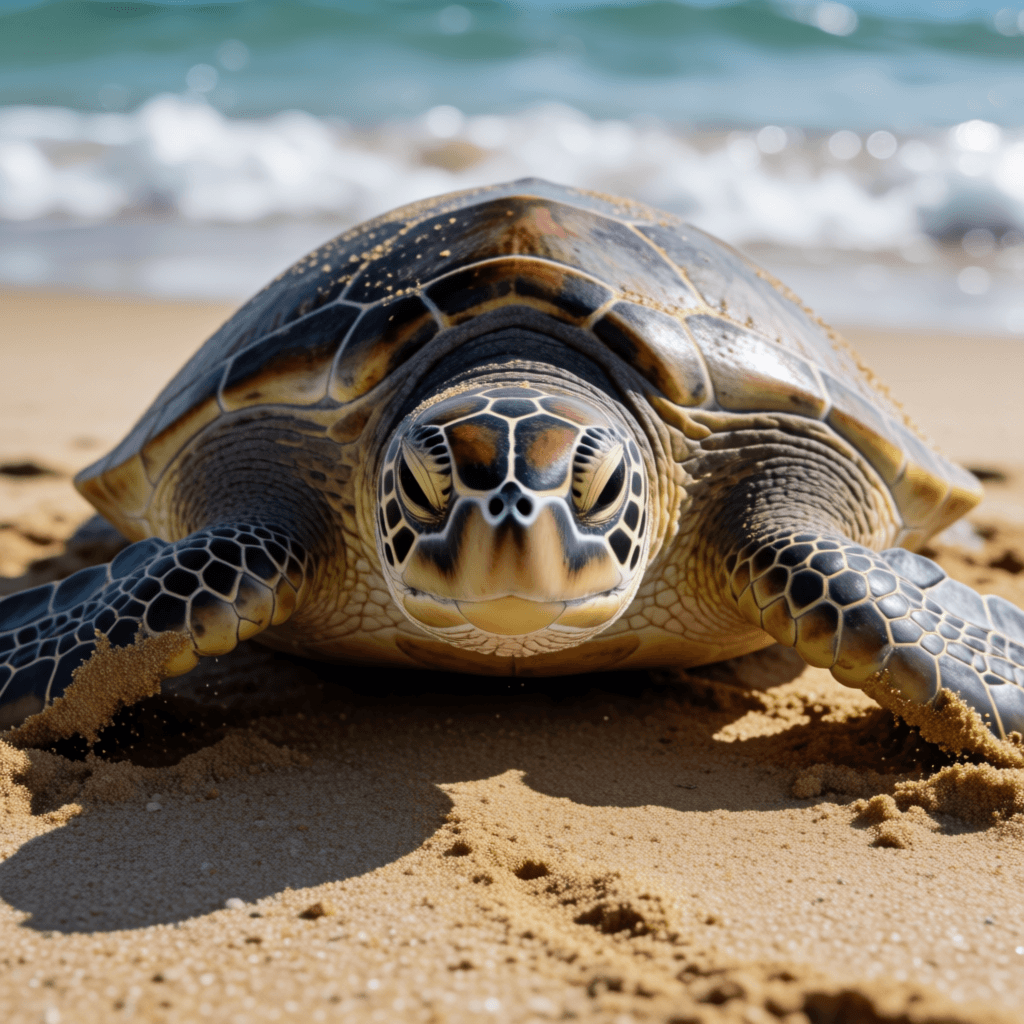
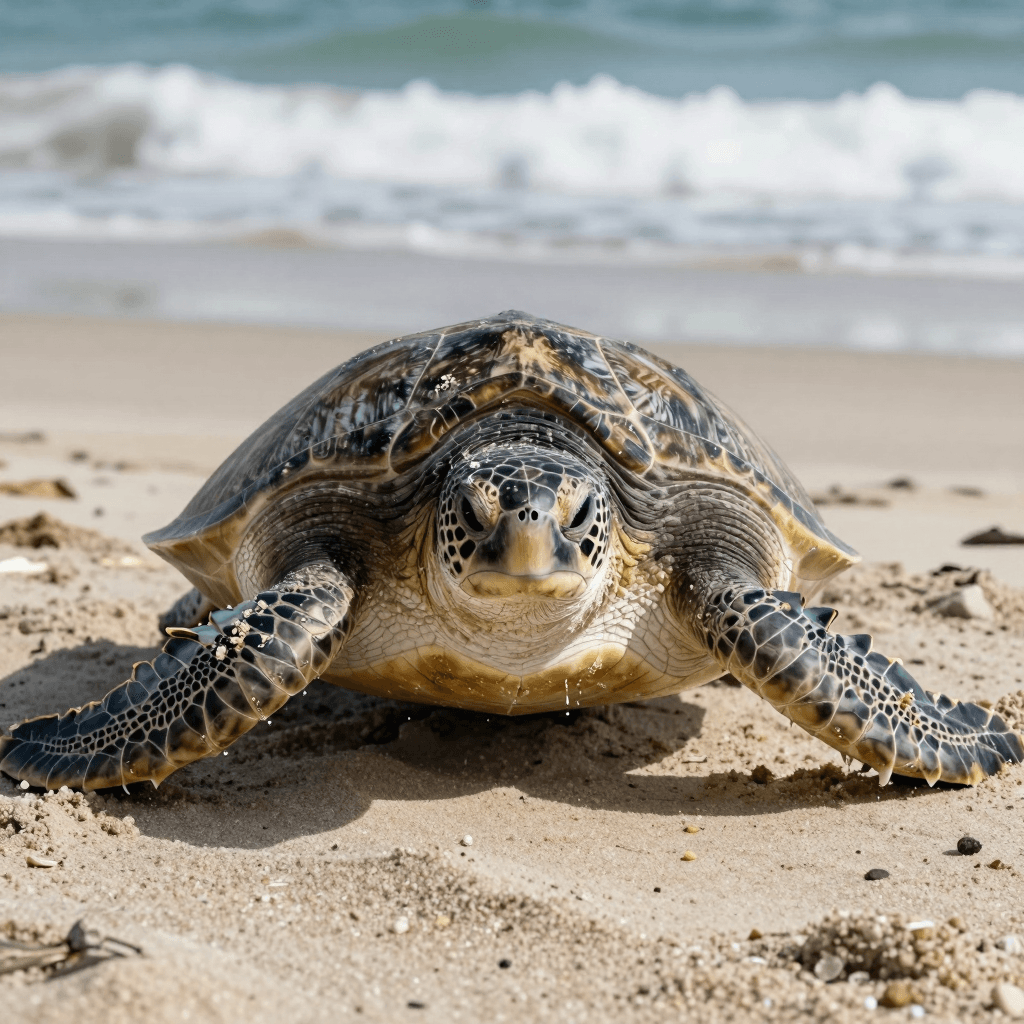
Ik heb de modellen getest door 3 prompts te testen.
Prompt #1
A lone european man stands on a weathered wooden raft with a torn, patched sail, adrift on an endless open ocean. The raft is built from salvaged wood, rope, and rusted metal scraps. Choppy waves and sea spray surround him under a dramatic, overcast sky with golden light breaking through the clouds. The shot is wide and cinematic, emphasizing how small the raft looks against the vast sea.


Prompt #2
A photorealistic photograph of a man and woman at a beachfront bar, each holding a tropical cocktail garnished with fruit. The sun sets behind them in warm golden and orange tones, reflecting off the ocean. They sit close, relaxed and smiling, looking at each other. Warm, cinematic golden-hour lighting gives the image a natural, high-end travel photography feel.



Prompt #3
A photorealistic close-up photograph of a sea turtle crawling across the sand, shot from directly in front of it as it moves toward the ocean. Its head faces the camera, textured shell and flippers in sharp focus, with grains of sand clinging to its skin. The ocean waves are visible in the blurred background just behind the turtle.


Conclusie & resultaten
| Model | Aantal seconden | Kwaliteit | Interpretatie prompt |
|---|---|---|---|
| Flux 2 Klein | 00:02:12 | 8 | 8 |
| Krea 2 Turbo | 00:13:08 | 8 | 9 |
| Z-Image Turbo | 00:05:35 | 9 | 8 |
| Qwen Image 2512 | 00:13:25 | 8 | 9 |
Flux 2 Klein 4B is het kleinste model van de geteste modellen, en dat is vooral terug te zien in de snelheid. Op een Mac duurt het ongeveer twee minuten om een afbeelding van 1024 × 1024 pixels te genereren. Ook de snelheid van Z-Image Turbo is nog goed acceptabel.
Omdat de kwaliteit van de gegenereerde afbeeldingen bij de verschillende modellen relatief dicht bij elkaar ligt, zou ik op een Mac M1 met 16 GB geheugen in de meeste gevallen kiezen voor Flux 2 Klein 4B. De combinatie van snelheid, beeldkwaliteit en het relatief lage formaat van het model maakt dit voor deze hardware een aantrekkelijke en praktische keuze.

